مدل هوش مصنوعی ارزان در چراغ: DeepSeek و Qwen برای چه کاری
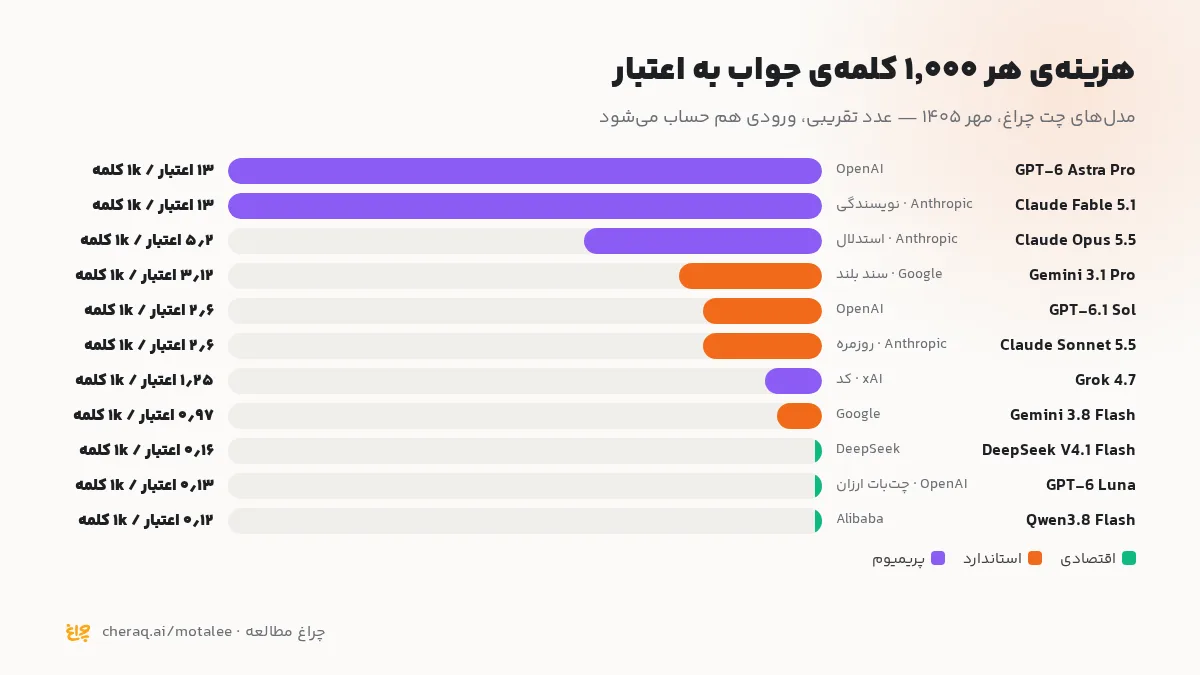
مدل هوش مصنوعی ارزان در چراغ یعنی سه مدل اقتصادی که بیشتر کارهای پرتکرار را با هزینهای نزدیک به صفر راه میاندازند: DeepSeek V4.1 Flash (حدود ۰٫۱۶ اعتبار برای هر ۱٬۰۰۰ کلمه) برای کد و تحلیل با زمینهی بلند، Qwen3.8 Flash (حدود ۰٫۱۲ اعتبار) برای PDF سنگین، کد طولانی، ویدیو و نمودار، و Qwen3.8 27B (تقریباً رایگان) برای پاسخ آنی، پشتیبانی و ویرایش فارسی. برای دستهبندی، خلاصه، پیشنویس و چتبات پرحجم کافیاند؛ برای کپی نهایی و استدلال چندمرحلهای نه. قانون سادهاش: با مدل ارزان فکر کن و پیشنویس بزن، فقط نسخهی نهایی را به مدل پریمیوم بده.
سه مدل اقتصادی چراغ در یک جدول
جواب کوتاه جدول: کد و تحلیل فنی به DeepSeek V4.1 Flash، فایل و PDF سنگین به Qwen3.8 Flash، جواب فوری و ویرایش فارسی به Qwen3.8 27B. هر سه در انتخابگر چت چراغ پیشفرض روشناند و دکمهی «راهنما» کنار انتخابگر ردهی اقتصادیشان را نشان میدهد. قیمتها تقریبی و برای ۱٬۰۰۰ کلمهی جواب است؛ متن ورودی هم حساب میشود.
| مدل | سازنده | ≈ اعتبار / ۱٬۰۰۰ کلمه | با نرخ امروز (تومان) | بهترین برای | ضعف |
|---|---|---|---|---|---|
| DeepSeek V4.1 Flash | DeepSeek | ۰٫۱۶ | حدود ۴۲۰ | برنامهنویسی و تحلیل با زمینهی خیلی بلند، پاسخ فنی ارزان | پرامپت باید شفاف باشد |
| Qwen3.8 Flash | Qwen (Alibaba) | ۰٫۱۲ | حدود ۳۱۰ | چندوجهی: تحلیل PDF سنگین، کد طولانی، ویدیو و نمودار | لحن ادبی فارسی ضعیفتر |
| Qwen3.8 27B | Qwen (Alibaba) | تقریباً رایگان | تقریباً رایگان | پاسخ آنی و پشتیبانی مشتری، ترجمه و ویرایش فارسی، اسکریپت کوتاه | زمینهی محدودتر، استدلال چندمرحلهای ضعیفتر |
قیمت هر مدل در چراغ به اعتبار ثابت است و با نوسان تومان عوض نمیشود. ۱ اعتبار یک سنت دلار است و با نرخ امروز حدود ۲٬۶۰۰ تومان؛ فقط قیمت تومانیِ خرید اعتبار با نرخ روز دلار حساب میشود. قیمتها تا ۲۶ مهر ۱۴۰۵؛ عدد بهروز هر مدل در صفحهی مدلها و قیمتها است. اعتبار رایگان روزانه (در حد ۱۰ اعتبار) برای این سه مدل یعنی دهها جواب بلند در روز، بیآنکه اعتبار خریداریشدهات دست بخورد.
DeepSeek V4.1 Flash: کد و تحلیل با زمینهی بلند
DeepSeek V4.1 Flash مدل اقتصادیای است که برای برنامهنویسی و تحلیل با زمینهی خیلی بلند ساخته شده و پاسخ فنی ارزان میدهد. هر ۱٬۰۰۰ کلمه حدود ۰٫۱۶ اعتبار، یعنی با نرخ امروز حدود ۴۲۰ تومان. ضعفش این است که پرامپت باید شفاف باشد؛ اگر مبهم بپرسی، جواب مبهم میگیری.
کجا جواب میدهد
- بررسی یک فایل کد طولانی: فریلنسری که قالب ووکامرس مشتری را نگه میدارد، فایل functions.php چندصد خطی را میچسباند و میپرسد کدام تابع کند است و چرا.
- تحلیل لاگ و خروجی حجیم: مدیر فنی یک فروشگاه آنلاین لاگ خطای یک هفته را میدهد و فهرست خطاهای پرتکرار با علت احتمالی میخواهد.
- اسکریپتهای روزمره: اسکریپت Python برای تبدیل CSV سفارشها به گزارش هفتگی، یا تابع کوچک جاوااسکریپت برای فرم سایت.
پرامپت شفاف یعنی چه
سه چیز را همیشه بنویس: ورودی دقیقاً چیست، خروجی دقیقاً چه شکلی باشد، و چه چیزی را نباید تغییر دهد. پرامپت نمونه: «این فایل PHP را بخوان. فقط توابعی را که به پایگاه داده وصل میشوند فهرست کن، برای هر کدام یک خط بگو چه میکند و اگر کوئری بدون ایندکس دارد بنویس. چیزی را بازنویسی نکن.» همین سه قید فرق جواب خوب و جواب سرگردان است.
Qwen3.8 Flash: چندوجهی ارزان برای فایل، کد، ویدیو و نمودار
Qwen3.8 Flash ارزانترین مدل چندوجهی فهرست پیشفرض چراغ است: تحلیل PDF سنگین، کد طولانی، ویدیو و نمودار. هر ۱٬۰۰۰ کلمه حدود ۰٫۱۲ اعتبار، یعنی با نرخ امروز حدود ۳۱۰ تومان. ضعفش لحن ادبی فارسی است؛ برای فهمیدن و استخراج عالی است، برای نوشتن متنی که قرار است منتشر شود نه.
از ۲۶ مهر ۱۴۰۵ چت چراغ فایل میخواند: Word، Excel، PowerPoint، PDF (تا ۲۰ صفحه بهصورت کامل)، CSV و کد، تا ۱۰ فایل در هر پیام. همین ترکیب Qwen3.8 Flash را به ابزار روزمرهی کسبوکارهای کوچک تبدیل میکند:
- کاتالوگ تأمینکننده: فروشگاه اینستاگرامی لوازم آشپزخانه PDF قیمت تأمینکننده را میدهد و میگوید «جدول نام کالا، قیمت و حداقل سفارش را دربیاور و بهصورت Excel بده».
- نمودار و گزارش: صاحب کافه عکس نمودار فروش ماهانهی نرمافزار حسابداری را میفرستد و میپرسد کدام ماهها افت داشته و چقدر.
- مقاله و استاندارد فنی: آموزشگاه زبان یک PDF آموزشی ۲۰ صفحهای را خلاصه میکند تا طرح درس بسازد؛ متن نهایی طرح درس را بعداً به مدلی با فارسی بهتر میدهد.
قاعدهی کار با Qwen3.8 Flash: از آن بخواه «پیدا کن، جدول کن، خلاصه کن»، نه «قشنگ بنویس». خروجی را بهصورت فهرست یا جدول بخواه تا ضعف لحنش اصلاً دیده نشود.
Qwen3.8 27B: تقریباً رایگان برای پاسخ آنی و فارسی روزمره
Qwen3.8 27B مدلی است که در چراغ تقریباً رایگان است و برای پاسخ آنی و پشتیبانی مشتری، ترجمه و ویرایش فارسی و اسکریپت کوتاه ساخته شده. ضعفش زمینهی محدودتر و استدلال چندمرحلهای ضعیفتر است. پس سند بلند و مسئلهی چندشرطی را به آن نده؛ کار کوتاه و پرتکرار را بده.
- چتبات پرحجم: پشتیبانی سایت فروشگاهی که روزی صدها سؤال تکراری دربارهی ارسال، سایز و مرجوعی میگیرد. سرعت و قیمت اینجا از همه چیز مهمتر است.
- ویرایش فارسی فوری: غلط املایی و نیمفاصلهی یک پیام قبل از ارسال به مشتری؛ یکدستکردن لحن ۵۰ جواب آمادهی دایرکت.
- ترجمهی کوتاه: پیام انگلیسی تأمینکنندهی خارجی به فارسی و جواب فارسی تو به انگلیسی، در چند ثانیه.
- دستهبندی: ۲۰۰ پیام دایرکت را در پنج دسته بگذار و تعداد هر دسته را بگو.
اگر کپیرایتینگ و لحن ادبی میخواهی، خانوادهی Claude 5.5 انتخاب درستتری است؛ Qwen3.8 27B برای «درست و سریع» است، نه «زیبا».
کجا مدل ارزان کافی است و کجا نه
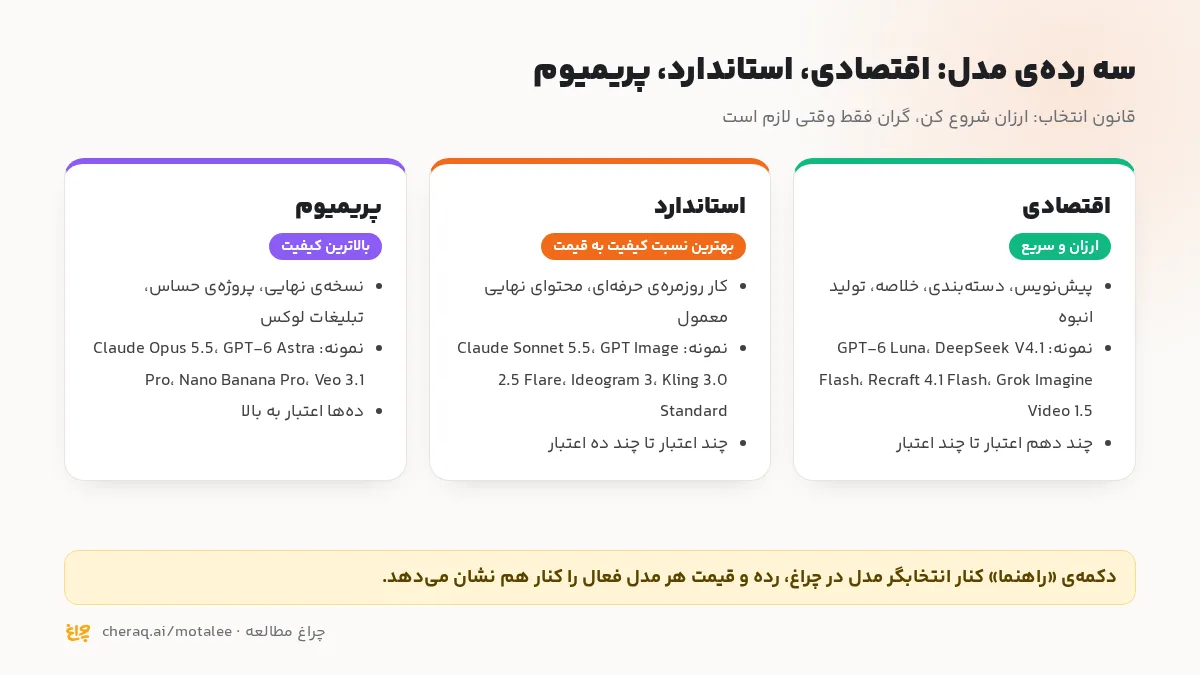
مدل ارزان جایی کافی است که اشتباهش ارزان باشد و یک نفر قبل از انتشار خروجی را ببیند. جایی کافی نیست که متن مستقیم جلوی مشتری میرود یا تصمیمی چندمرحلهای پشت آن است.
کافی است
- دستهبندی و برچسبزدن: پیامها، نظرها، تیکتها، محصولها.
- خلاصه و استخراج: PDF، گزارش، صورتجلسه، نظرهای مشتریها.
- پیشنویس: ساختار مقاله، ایدهی پست، نسخهی اول ایمیل.
- چتبات پرحجم: سؤالهای تکراری با جوابهای مشخص.
- کد روتین: اسکریپت کوچک، تبدیل فرمت، توضیح یک تکه کد.
کافی نیست
- کپی نهایی: متن بنر، کپشن اصلی کمپین، صفحهی فرود. اینجا Claude Sonnet 5.5 برای کار روزمره و Claude Fable 5.1 برای نسخهی نهایی.
- استدلال چندمرحلهای: مقایسهی سه پیشنهاد تأمینکننده با شرطهای گرهخورده، سناریوی قیمتگذاری سال بعد. اینجا GPT-6 Astra Pro یا Claude Opus 5.5.
- سند حقوقی و مالی: قراردادی که امضا میشود؛ دستکم GPT-6.1 Sol.
هزینهی ۱۰۰ هزار کلمه: ارزانها در برابر GPT-6 Luna و Claude Sonnet 5.5
قیمت هر هزار کلمه بهتنهایی حس نمیدهد؛ یک ماه کار پرحجم را ببین. فرض کن چتبات پشتیبانی یا خط تولید محتوای یک تیم کوچک در ماه ۱۰۰ هزار کلمه جواب از مدل میگیرد (مثلاً ۲٬۰۰۰ جواب ۵۰ کلمهای، یا ۱۰۰ متن هزارکلمهای). اعداد تقریبی و با نرخ امروز است.
| مدل | رده | اعتبار برای ۱۰۰ هزار کلمه | با نرخ امروز (تومان) |
|---|---|---|---|
| Qwen3.8 27B | اقتصادی | تقریباً رایگان | تقریباً رایگان |
| Qwen3.8 Flash | اقتصادی | حدود ۱۲ | حدود ۳۱٬۲۰۰ |
| GPT-6 Luna | اقتصادی | حدود ۱۳ | حدود ۳۳٬۸۰۰ |
| DeepSeek V4.1 Flash | اقتصادی | حدود ۱۶ | حدود ۴۱٬۶۰۰ |
| Claude Sonnet 5.5 | استاندارد | حدود ۲۶۰ | حدود ۶۷۶٬۰۰۰ |
سه نکته از جدول. اول، سه مدل اقتصادی چراغ و GPT-6 Luna عملاً در یک محدودهاند؛ انتخاب بینشان را نوع کار تعیین میکند، نه قیمت: کد به DeepSeek، فایل به Qwen3.8 Flash، پاسخ فوری به Qwen3.8 27B، متن شبکهی اجتماعی به Luna. دوم، فاصله با ردهی استاندارد واقعی است: ۱۰۰ هزار کلمه با Claude Sonnet 5.5 بیش از ۱۶ برابر DeepSeek V4.1 Flash خرج دارد. سوم، این فاصله دلیل نمیشود همهی کار را به مدل ارزان بدهی؛ دلیل میشود کار را دو مرحلهای کنی. مقایسهی کامل سه مدل GPT-6 در خانوادهی GPT-6 آمده است.
گردش کار دو مرحلهای: ارزان بساز، پریمیوم صیقل بده
بیشتر هزینهی چت در رفتوبرگشتهای اول خرج میشود، نه در نسخهی نهایی. پس حجم را به مدل اقتصادی بده و فقط چیزی را که منتشر میشود یا تصمیم پشتش است، یک بار به مدل استاندارد یا پریمیوم بسپار.
- مرحلهی اول با مدل ارزان: استخراج، دستهبندی، خلاصه، پیشنویس، چند دور رفتوبرگشت. Qwen3.8 Flash برای فایل، DeepSeek V4.1 Flash برای کد، Qwen3.8 27B برای جوابهای کوتاه.
- انتخاب: از همهی خروجیها فقط آنهایی را نگه دار که واقعاً جلوی مشتری میروند یا تصمیمی را میسازند؛ معمولاً کمتر از ده درصد.
- مرحلهی دوم با مدل قوی: همان ده درصد را با Claude Sonnet 5.5 بازنویسی کن، یا اگر تصمیم مالی است یک بار به GPT-6 Astra Pro بده. یک دور، نه پنج دور.
حساب کنیم. همان تیم ۱۰۰ هزار کلمه پیشنویس و استخراج را با Qwen3.8 Flash میگیرد (حدود ۱۲ اعتبار) و ۱۰ هزار کلمهی نهایی را با Claude Sonnet 5.5 (حدود ۲۶ اعتبار). جمع حدود ۳۸ اعتبار، یعنی با نرخ امروز حدود ۹۹٬۰۰۰ تومان. اگر همهی ۱۱۰ هزار کلمه را از اول با Claude Sonnet 5.5 میزد، حدود ۲۸۶ اعتبار یعنی حدود ۷۴۴٬۰۰۰ تومان میشد. کیفیت جایی که مهم است استاندارد است و هزینه کمتر از یکهفتم.
دو ابزار چراغ این گردش کار را آسان میکند. «مقایسهی مدلها» کنار دکمهی ساخت یک پرامپت را همزمان روی تا ۳ مدل میفرستد؛ یک بار DeepSeek V4.1 Flash، Qwen3.8 Flash و Claude Sonnet 5.5 را کنار هم بگذار تا ببینی برای کار خودت فاصلهی کیفیت چقدر است. و «حافظهی من» با هر مدلی همراهت میآید؛ اسم برند و لحن را یک بار مینویسی و بین مدل ارزان و گران بدون توضیح دوباره جابهجا میشوی. فهرست کامل ۱۲ مدل چت پیشفرض در راهنمای مدلهای چت و نوشتن است.
مدل ارزان در API: چتبات و اتوماسیون پرحجم
اگر چتبات یا اتوماسیون میسازی، همین سه مدل جاییاند که هزینهی ماهانهات تعیین میشود. API چت چراغ کاملاً سازگار با OpenAI است: کتابخانهی رسمی OpenAI را بردار و فقط base_url را به https://cheraq.ai/api/v1 عوض کن. شناسهی دقیق هر مدل و هزینهی تقریبیاش را GET /models برمیگرداند؛ نام مستعار auto هم مدل پیشنهادی چراغ را برای همان نوع کار انتخاب میکند.
الگوی دو مرحلهای در کد هم همان است: درخواستهای پرحجم (دستهبندی تیکت، خلاصهی گفتگو، جواب اول چتبات) با شناسهی ثابت یک مدل اقتصادی، تا قیمتت قابل پیشبینی بماند؛ و فقط وقتی مدل ارزان مطمئن نیست یا مشتری ناراضی است، همان گفتگو به مدل استاندارد پاس داده میشود. برای چتبات، max_tokens کوتاه بگذار تا جوابها هم سریعتر و هم ارزانتر شوند. راهنمای کامل و نمونهکد در API چراغ برای برنامهنویسها و مستندات API است.
سؤالهای رایج
ارزانترین مدل هوش مصنوعی در چراغ کدام است؟
Qwen3.8 27B که تقریباً رایگان است و پاسخ آنی میدهد. بعد از آن Qwen3.8 Flash با حدود ۰٫۱۲ و GPT-6 Luna با حدود ۰٫۱۳ اعتبار برای هر ۱٬۰۰۰ کلمه.
فرق DeepSeek V4.1 Flash و Qwen3.8 Flash چیست؟
DeepSeek V4.1 Flash برای کد و تحلیل فنی با زمینهی خیلی بلند است و پرامپت شفاف میخواهد. Qwen3.8 Flash چندوجهی است و برای PDF سنگین، کد طولانی، ویدیو و نمودار، ولی لحن ادبی فارسیاش ضعیفتر است.
آیا مدل ارزان برای نوشتن کپشن اینستاگرام کافی است؟
برای ایده و پیشنویس بله؛ GPT-6 Luna و Qwen3.8 27B کافیاند. کپشن اصلی کمپین را یک بار به Claude Sonnet 5.5 یا Claude Fable 5.1 بده.
آیا با اعتبار رایگان روزانه میشود این مدلها را جدی استفاده کرد؟
بله. اعتبار رایگان روزانه در حد ۱۰ اعتبار است و با مدلهای اقتصادی یعنی دهها جواب بلند در روز. اول از اعتبار رایگان خرج میشود، بعد از خریداریشده.
اگر جواب مدل ارزان خوب نبود، اعتبارم هدر رفته؟
اگر کار ناموفق باشد اعتبار کم نمیشود. اگر جواب آمد ولی کافی نبود، هزینهاش در حد چند صد تومان است و همان پرامپت را به مدل قویتر میدهی.
یک پرامپت از کار واقعی خودت را به DeepSeek V4.1 Flash یا Qwen3.8 Flash بده و ببین چند صد تومان تا کجا میرسد.